【Excitech Camp!!!】生成AIで1日22ページ実装したら、レビューが1日で終わらなかった話

はじめに

はじめまして。情報系を専攻する学部3年の小出です。 2026年9月の1ヶ月、【Excitech Camp!!!】28卒就業型サマーインターン 2026に参加しました。

生成AIにコードを書かせて、次々に形になっていくのが気持ちいい。 そういう感覚、わかる人は多いと思います。私もそのひとりです。

この記事では、その「気持ちよさ」に乗って走った結果、実務でどうなったかを1つだけ書きます。


何をしていたか

配属先は、恋愛相談サービス「恋ラボ」の開発チームです。 古い技術で作られたアプリ(PHP, BEAR.Saturday)を、新しい技術(PHP, Laravel 13)で作り直すプロジェクトに参加しました。

私の担当は、利用規約や料金案内などの「ヘルプ」ページです。 ルールは、ユーザーから見て、旧アプリと何も変わらないこと。


1日で22ページ書けてしまった

1日目は、利用規約ページを1枚だけ作りました。 旧アプリのコードを読み、Laravelの書き方を覚えながら、ブラウザで表示を確かめる。ここまでは普通です。

2日目、流れがつかめたので生成AIにどんどん実装を任せました。 すると、とんでもない速さでページができていきます。

  • その日PRに出す予定の5ページ
  • さらに、先の予定だった17ページ

合計22ページ分のコードが、1日でできてしまいました。 正直、かなり気持ちよかったです。


でも、レビューが追いつかない

問題はここからです。 実務では、コードは書いたら終わりではありません。

  1. 自分でコードを読んで確認する
  2. PC版とスマホ版を、ブラウザで旧アプリと見比べる
  3. PRを出して、チームのレビューを受ける

AIは速く書いてくれますが、確認するのは人間です。 22ページ分のコードを、1日で読み切ることはできませんでした。

しかも、確認していくと不具合が見つかりました。 スマホ版で、パンくずリスト(ページ上部の「ホーム > ヘルプ > …」という現在地表示)の表示が欲しいところにありませんでした。

原因を探すため、旧アプリの共通レイアウトのファイルを読みました。 すると、こんな違いが見つかりました。

  • PC版:パンくずは本文の前
  • スマホ版:パンくずは本文の後ろ(フッターの直前)

実際の表示やコードを自分の目で確かめないと、正しいかどうかは判断できないと思い知りました。

結局この日は、確認できた分だけコミットしました。 残りは別のブランチに退避して、次の日以降に回しました。


速すぎると、後ろの工程が詰まる

この日の日報に、私はこう書きました。

実装速度に業務全体のペースを引っ張られると、後工程(レビュー・動作確認)がボトルネックになることを実感した

書くスピードがいくら上がっても、確認するスピードは上がりません。
作りすぎたコードはまだ使えず、置いておくことしかできません。

そこで、進め方を変えました。

  • レビューにかけられる時間から逆算して、AIに任せる量を決める
  • AIには「旧アプリの元ファイルを必ず確認して」と指示に入れる
    • HTMLとCSSの差分がないことを検証する

最終的に、1ヶ月で担当のヘルプページ29ページをすべて移植できました。


まとめ:気持ちよさは「書いた量」より「届けた量」で

AIを使えば、コードを書く量はいくらでも増やせます。 でも、チームで作るサービスで大事なのは、確認されて、本番に届いたコードの量です。

だから、書く前に一度だけ考えてみてください。

  • 今日書いた分を、今日レビューしきれるか?
  • 「正しい」と言える根拠を、元の情報で確かめたか?

AIで速く書けること自体は、すごく強い武器です。 その強さを、最後の工程まで見て使えるエンジニアを目指したいと思います。

【Excitech Camp!!!】28卒就業型サマーインターン2026を通して

はじめに

こんにちは、28卒インターン生の上中野 瑞人です!
エキサイト株式会社のExcitech Camp!!!にてBB事業部(ブロードバンド)で9月から1ヶ月間、参加させていただいております。

インターンを通した個人での開発や学生でのチーム開発との違いと長期的に保守できるシステムに関する考えについて執筆します。
なんで保守されるじゃなくてできるなのかはこれまた後ほど・・・

自己紹介

大阪産業大学 デザイン工学部 情報システム学科の学部3年生です。
小学生の頃からBASICやHTMLに触れてきてJavaやPHPなど様々なプログラミング言語でパソコンを用いて何かを作ることに楽しさを感じていました。しかし、ハッカソンや身内でのチーム開発とは異なる、実際の業務を通じてチームの一員として開発をしていく流れを学びたいと思い、僕の中では初めての長期インターンとしてExcitech Camp!!!に参加させていただいています!

事前学習

  • Webを支える技術
  • ソフトウェアアーキテクチャの基礎
  • 良いコード/悪いコードで学ぶ設計入門

上記の3冊に加え、Laravelの経験もまだまだ浅いため、一度ハンズオンで開発環境構築からやり直してみました。 特にWebを支える技術ではウェブの歴史的な経緯や僕自身が知らないこと、知っていたことをより詳細に深掘りできて面白い1冊でした。

1ヶ月でやったこと

1ヶ月の中で主に「API移行作業」を行いました。流れとしてはメンターの方が記述したチケットの内容から要件を確認してAPI設計書を作成し、相談しながら実装してレビューを経てデプロイするというものでした。

また、実装だけではなく、APIの動作確認やUnit/Featureテストの作成、レビューを受けた上での修正など、実際の開発の流れを一通り経験しました。

終盤近くでは社内ツールの旧ツールから新ツールへの移植と改善なども行いました。

よかったこと

実際に利用されている既存システムを通じて開発できたことです。

これまでは個人での開発やハッカソンなどで開発することはあり、実際にユーザーの持つサービスやソフトウェアを開発、運用する経験もありました。しかし、そこでは自分たちで決めたものを自分たちで作ることが多く、基本的に自分自身がコードや仕様を把握しているので、今回のような自分以外の人たちが継続的に開発をしている既存システムに対して変更を加えるという経験はありませんでした。

今回は既存のAPIを新たなLaravelのAPI開発環境下に移行する作業だったため、単純に動くものを作るだけでなく、既存の処理がどのように使われているか、変更するとどこに影響するのかを考えながら進める必要がありました。

また、実装をする中で疑問点なども発生します。そのため、相談しながら進める中でただ単に質問するだけでなく自分なりの対応案などを考えてから話し合うことで、よりスムーズに進めることができることも学びました。

難しかったこと

こちらは既存システムのコードの理解とテストの設計、作成です。

個人での開発では自分で書いたコードを扱うことが多いため、なぜこの処理が必要なのかを把握しやすいですが、今回は自分が書いたものではない既存のコードを読み解く必要がありました。

また、MVCではなくService、Repositoryといった概念もDBに触れることが少なかった僕にとっては新たなものでした。

そのため、ルーティング、コントローラ、サービス/リポジトリ、モデルというように処理の流れを追いながら、実際にどのような処理が行われているのかを確認していきました。

また、最初はどこまで自分で考えてから相談すればよいのか分からない部分もありました。実際に相談していく中で、分からないことをそのまま聞くのではなく、自分なりに調査してそこから自分なりに対応案を考えて出した上で相談することが重要だと分かりました。

本題とはズレますが、普段WindowsやLinuxユーザーであるため、実はmac特有のキーボード操作にも手こずっていました。バックスラッシュの入力方法が分からず、option + ¥で入力できることを知ったりなど、MacBook自体は持っているものの開発にはあまり用いることがなかったため、macOSをメインに開発すること自体も初めての経験でした。

これから先挑戦したいこと

今回の経験を通して、実装するだけでなく、その後も複数人で維持していけるようなシステムを考えながら開発できるようになりたいと思いました。
これは僕自身が参加している部活動のシステムも同じくトレンド技術を選定してしまったことにもつながるからです。

特に、アーキテクチャや技術スタックを選定するときに、今作りやすいかどうかだけではなく、今後その技術を扱える人がいるのか、学習コストはどの程度なのかなど、将来的なことまで考えられるようになりたいです。

また、今回のような既存システムの移行作業だけでなく、より大きな変更をするときの影響範囲やスコープを考え、どこまで対応するべきなのかを判断できるようになることにも挑戦したいです。

それと、Laravelに関してはまだまだわからないことだらけなので、この頃は休みの合間に個人での開発でも取り入れてます!

学び

個人での開発や学生でのチーム開発との違い

今回のインターンを通して、個人での開発やハッカソンなどの学生同士のチーム開発と、実際の仕事としてのシステム開発では考えることが大きく異なると感じました。 (ただし、これも個人プロジェクトをOSS化する際や部活動のシステムを作る際は効いてくると思います)

個人で開発する場合は、自分が使いたい技術やトレンドの技術などから技術スタックを選ぶことが多く、ある程度自分の判断で自由に進めることができます。

一方で、実務上の既存システムでは自分以外の人も開発や保守に関わっています。そのため、技術の選定だけでなく、既存システムへの影響や開発する範囲、今後の保守なども考える必要があります。

今回のAPI移行では、影響範囲の小さなエンドポイントの移行でした。しかし、レスポンスを変更すればフロント側にも変更が必要になります。1つの変更でも他の部分に影響することがありました。

また、個人での趣味的な開発では移行作業を行うことは滅多になく、既存コードを読み解くというのもオープンソースに関わる以外ではあまり行うことがありませんでした。

今回、実際の既存システムを扱ったことで、コードを書くことだけではなく、「既にあるものをどう変更するか」という視点を持つことができました。

長期的に保守できるシステムについて

僕の大きな学びとしては、長く利用され続けるシステムにおいて「アーキテクチャや技術の選定」が鍵となるということでした。 もともと個人で開発する上ではトレンドである技術や学びたい言語から技術スタックを選ぶことが多かったのですが、ここで重要となるのは、維持できるシステムを作るには金銭的コストだけでなく学習コストや人員なども関わってくるということです。

例えば、どれだけ技術的に優れた構成であったとしても、その技術を扱える人が少なければ、将来的に担当者が変わったときに保守することが難しくなる可能性があります。

この学びから僕自身もアーキテクチャや技術スタックの選定を今後のことも視野に入れて複数人で長期的に維持できるものにする力を身に付けたいという目標も明確になりました。

今回の経験から、そもそもシステムは「保守されるもの」として考えるのではなく、「保守できるもの」として設計することが重要なのではないかと考えるようになりました。

また、既存コードを読み解く上でルーティング、コントローラ、サービス/リポジトリ、モデルの流れで確認し、言葉上の理解だけではわからないため、実際にどのような処理をしているのかを見ていきました。また、なぜRepositoryとInterfaceをそれぞれ別々で作成しているのかを考えるとテスト時に余計なDBアクセスを省いてモックできる利点があると思いました。

デプロイについても、テスト環境、ステージ環境、本番環境という複数の環境を使い分けていることを知り、実際のサービスでは開発したものをそのまま本番へ出すのではなく、安全に変更を適用するための仕組みが必要であることも学びました。
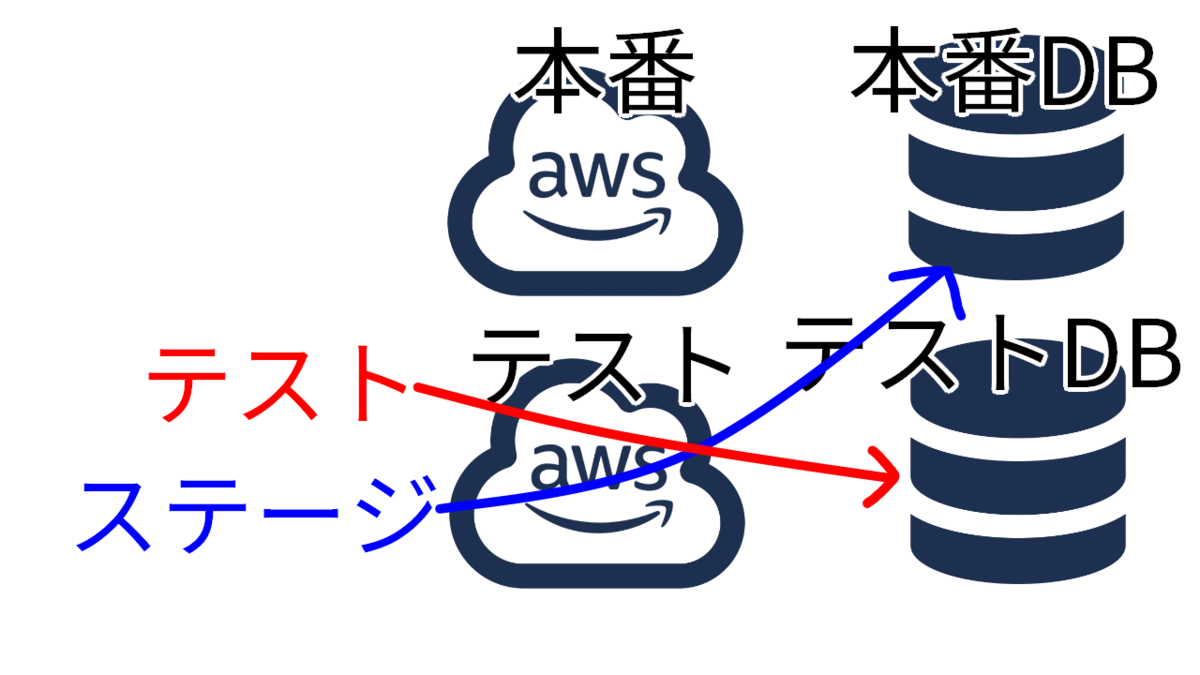
(デプロイ環境のイメージ、アイコンはFont Awesome Freeさまより)

また、今回の作業を振り返って、あらかじめ「共通化できるものの洗い出し」をしておけばよかったと感じました。

技術選定の理由を言語化する習慣

メンターの方とお話しする中で、技術選びの考え方など、自分自身が気づかないうちに技術スタックを選んでいる理由、「なぜ、〇〇を選んだのか?」を「見える化」することの必要性に気づきました。

例えば、僕は「無料でサイトを運用したいからSSGを選ぶ」や「基本一人で開発するが、今後二人ほどOSSにコントリビュートしてくれるかもしれないのでドキュメントを整備しておく」などのように、普段は無意識に判断していることも「なぜその技術スタックや設計、リソースを用いたのか、選んだのか」といったことを言語化し、記録しておく習慣がとても重要であると思いました。

レビューを受けた上での学び

移行作業をする中でAPI移行対応としてフロント側のエンドポイント切り替えでAPI仕様を変更した際に型の考慮など見落としていることがありました。

また、パスパラメータ(例えばGET /api/user/{id})では、そのパラメータがなければそもそもルーティングされないのでパラメータが必須であるというバリデーションは不要であるということも学びました。

このように、同じバリデーションでもどこから値が渡されるのかによって必要な確認が異なり、APIを実装するときには単純に値をチェックするだけではなく、ルーティングや型なども含めて考える必要があると分かりました。

さいごに

今回のインターンの中で開発だけでなく、設計やテストの作成など多くのことを経験し、考え方なども学びました。

リモートであるため、人と関わるのは画面内やSlackでしたので実際にオフィスでも働いてみたい!と思いました。

また、もしかしたらものすごく当たり前のことを言っているのかもしれませんが、AI時代(AI時代じゃなくてもそうだけど)だからこそシステムは保守できる人がいないと維持できないということに気付かされました。

どうしても個人の開発では流行りや好きな技術、アーキテクチャを選びがちになりますが、学習コストや技術を利用できる人員数から考えて維持できるかどうかはまた別であるというのが大きな学びでした。

僕自身の知らない領域、学校の勉強や個人開発、資格試験では得られない、想像以上の実務経験とエンジニアとしての学びがあり、大変良かったです。そのため、リソースなども考慮した長期的に保守できるシステムを設計から考えられるITエンジニアになりたいとより明確に目標が僕の中で定まりました。

BB事業部のメンターの方、エキサイトの皆様、1ヶ月、本当にありがとうございました!!

【Excitech Camp!!!】就業型インターン参加記

はじめに

28卒就業型サマーインターンにBB事業部で9/1~9/30の一ヶ月間参加させていただきました。この記事では一ヶ月間で経験したことを振り返りまとめたいと思います。

自己紹介

情報系専攻の学士3年(28卒)です。普段は主にバックエンドを書いていて、主な使用言語はJava, Go, Kotlinでした。これまでハッカソンや個人開発などを経て、実務形式のインターンは2度目の経験でした。

そのほかの開発経験として、マインクラフトのmod・プラグイン開発も行っています。

インターンで取り組んだこと

1. フロントエンドNext.js, React, Node.jsのバージョンアップ

Next.jsのバージョンアップと、それに伴う周辺環境のバージョンアップを行いました。

  • Next.js 13.2.4 → 15.5.25
  • React 18 → 19.2.8
  • Node.js 20.17.0 → 24.18.0

一気にバージョンアップすると変更箇所が増え複雑になってしまうため、Next.js 14を経由して2回に分けて行いました。

バージョンアップ作業が終わりGitHub Actionsを用いてtest環境へデプロイしようとすると失敗、原因はビルドキャッシュによるランナーのディスク容量不足でした。docker buildxの cache-to を mode=max から mode=min に変更し、保存するキャッシュを減らすことで対応しました。

test環境でのチェックと本番データを用いるstage環境でのチェックを終えると、本番環境への反映を行いました。権限管理の都合上操作はメンターの方に行っていただきその画面共有を見る形でしたが、ちょうど数日前に参加したイベントで知った手法であるブルーグリーンデプロイが実際に行われていることを体験することができました。

2. API移植

ウェブサイトで使用されているAPIの移植を行いました。ほかのAPIと共通で用いる基盤を元に、旧版の仕様の一部のリファクタリングを兼ねての移行でした。Jiraで渡された詳細内容・方針を元に設計書を作成し実装を行いました。旧APIでは、パラメータを省略した際に暗黙のデフォルト値で動く仕様や実際には使用されない形式を処理する仕様がありましたが、パラメータを必須にし使用する1形式のみを受け付ける仕様で実装しました。

3. 便利ツール制作

社内で用いる便利ツールの制作を行いました。このツールにも旧版が存在し、その仕様を元にしつつ新規機能の追加などを行いました。エンジニアだけでなくビジネス職の方なども用いるツールであるため、非エンジニアにもわかりやすい文言とエンジニアがログを見なくてもエラーの内容がわかるような文言を併記しました。社内の人のみが閲覧可能なため、エンジニア向け情報にはDBのカラム名など詳しい情報を記載するようにしました。

旧ツールはDBを直接参照せずAPI経由で情報を取得していたため非常に低速で、数百件程度を実質的な上限とする記載がありました。そのため、当初は多くても数千件程度の処理を想定していました。新ツールではDBに直接接続することで情報取得を高速化し、5000件まで一斉に処理できるようにしました。

一旦実装を完了させると、stage環境にデプロイし実際にツールを用いるエンジニア・非エンジニアの方々に試用していただくフィードバック会を行いました。これまで旧ツールを使用していた方々のフィードバックをいただくことで、よかれと思って実装した内容が実際はないほうが良かったり5000件の上限も実際には不十分で数万件の処理が必要だったりと自分で試すだけでは気づけないことに気づけました。

フィードバック会のあとは、細かな部分の改善を行いつつ、処理データ量の引き上げ方法を検討していきました。ボトルネックは主にバックエンドにおいてリクエストで受け取れるデータ量の制限が2MBに設定されていること、処理結果をすべてメモリ上に溜めるためPHPのメモリ上限を超えてしまうことでした。これに対して、以下の方法を検討しました。

  • フロント側でデータを少しずつバックエンドに送り処理する方法
    • リクエストデータについて重複を事前に除去する機能を持っていることからこの除去が分割した1回分ごとにしか効かなくなるため不採用
  • AWSのS3を用いて処理結果を積み上げていくことで処理中のメモリ使用量削減を行う方法
    • AWSの権限や知識が必要で実装が複雑になることから不採用
  • 送られたデータの処理を1000件ずつ行い処理が完了したデータからPHP, Laravelのstream機能を用いてNDJSON形式で返す方法
    • 処理が終わった分から返し、メモリ上に大量のデータを溜めずに済む
    • リクエストデータ量の上限である2MBは解消されないが、このデータ量でも10万件程度は処理可能で十分であると考え、採用

結果として、処理できる件数を5000件から10万件程度まで引き上げることができました。

AIの使用

インターン期間中、Claudeを活用していました。desktop appからClaude Codeを使用し、方針決定のサポートから実装、コードレビューまで行いました。コードレビューには /code-review を初めて使いました。今までは変更内容を確認してとプロンプトで指示していましたが、コマンドだと自動でサブエージェントを並行で走らせてくれてとても便利でした。ひとつタスクを任せながら待っている間にもうひとつのタスクをプロンプト書いて投げる、返ってきているものをレビューするなど効率的に進めることができました。

インターン終盤にはOpus 5.5がリリースされ使っていました。正直もはや明確な違いがわからなくなってきている感じもしますがより早く高い品質で大規模なコードを読み書きできるようになっているように感じました。

インターンとして自身の成長に役立てる上でAIを使わずにコードを書いたほうがいいのではという気持ちもありましたが、実際コードはAIが大部分を担うことが多い中で実務における仕様決定やフィードバック対応などのコミュニケーション面の経験を重視したいと考えAIをフル活用しました。実際実装とレビューのループを高速に回せたことでフィードバック会などを経験することができとても良かったと思います。

インターンを経て

一ヶ月計80時間程度のインターンで、フロントからバックエンド, インフラも少しと幅広く触れ、仕様策定やフィードバックなどを含めて実務の一連の流れを学ぶことができました。メンターを含むBB事業部の方々、人事の方々、貴重な経験をさせていただきありがとうございました。

【Excitech Camp!!!】就業型インターン 2026 を通して

はじめに

2026 年 9 月の 3 週間、エキサイトの就業型インターンに参加しました。 配属は FanGrowth(ウェビナーマーケティングのプラットフォーム)を開発しているチームで、 フロントエンドを中心に、実際に運用されているプロダクトのコードを触らせてもらいました。 やったことと、やってみて思ったことをまとめます。

自己紹介

情報学専攻の学部3年生です。これまで個人開発 / チーム開発 / ハッカソンなどで開発をしてきましたが、 チームで運用されているコードに、レビューを受けながら手を入れる経験がなかったので、それを目的に参加しました。

配属先で取り組んだこと

FanGrowth のフロントエンド(React + TypeScript)と、関連する社内向けダッシュボードで、3 つのタスクを担当しました。

1. 全ページにページタイトルを設定する

ブラウザのタブに出るタイトルが、多くの画面で「FanGrowth」だけになっていました。 全 114 ルートを洗い出して、どの画面にどんなタイトルを付けるかを決め、実装しました。

実装より命名が本体でした。URL の名前と画面の見出しが食い違っているページが 14 件あり、 どちらを採るかで利用者の見え方が変わります。1 件ずつ「画面の見出し」「左メニューのラベル」「コードの定義」のように 出所を辿れる根拠を付けて案を出し、メンターの方とのレビュー会で決めていきました。 社内で定着している呼び方に合わせた箇所もあって、そういう情報は調べても出てこないので、レビューで拾うしかないと分かりました。

2. ゲスト表示の企画共有ページを Figma に合わせる

共催ウェビナーのゲスト企業が見る画面を、デザイナーの Figma に合わせて直すタスクです。 3 つの中でいちばんしんどかったのがこれで、直しても直しても漏れがありました。詳しくは後で書きます。

3. 社内向けダッシュボードのテーブル改善

案件の一覧テーブルが横スクロールしないと全体を見られない状態だったので、案件名の列を左に固定しました。 position: sticky は区切り線が消える、max-width が効かない、フォーカス枠が塗り潰されるなど、 実機で見ないと気づけない罠が多く、CSS を書いては画面で確認する往復になりました。

タスク以外で見つけたもの

作業中に、ローカル環境で一覧ページが開けなくなる不具合に当たりました。 画面には「500」と出るのですが API は正常で、原因はフロント側の null 参照でした。 メンターの方に相談して別ブランチで修正し、PR にしました。 ほかにも作業中に見つけた不具合を 2 件、原因を調べてチケットの形にして残しました。

学んだこと

「今どうなっているか」が見えることの価値

まず環境の話から。用件や質問があるときに、Slack や Tandem で気軽に声をかけられる雰囲気がありました。 リモートワークだと相談のハードルが上がりがちですが、そこが工夫されていると感じました。

もう一つは Jira です。タスクが「作業前 / 進行中 / レビュー中 / チェック中 / 完了」に分かれていて、 どのタスクが今どの状態かを、自分以外の人からも確認できます。

これが良いと思ったのは、自分が別でやっているチーム開発と比べたからです。そちらは Discord で 「これやって」と頼む形で管理していて、頼んだ相手が今どこまで進んでいるのかを確認する場面と、 逆に自分が頼まれたタスクが何だったか、どのチャンネルで話したかを探す場面で手間がかかっていました。 状態が一か所に見えているだけで、その両方が消えます。ツールは Jira でなくてもいいのですが、 「見える場所を作る」のは自分のチームにも持ち帰りたいと思いました。

そして、これは自分がやる側でも同じでした。今回うまくやれたと思うのは、 タスクを始める前に「こう進めようと思っています」という前提確認をしたことと、進捗を適宜報告したことです。 上司の側から見れば「ちゃんと進んでいるのか」が見えるし、自分の側から見れば、方向性がずれて作業が無駄になるのを防げます。 実際、3 週間で方向がずれて作業をやり直す、ということはありませんでした。

AI に任せていいものと、自分の目で見なきゃいけないもの

インターン中は AI をかなり使いました。作業と呼べるものは、可能な限り任せたいと思っていました。

それで痛い目を見たのが Figma 合わせです。デザインの値を読み取って実装と突き合わせる、というのは まさに「作業」に見えたので任せていたのですが、レビューで指摘を受けて直しても、また別の箇所がずれていました。 2 回目に同じ領域を指摘されたとき、自分のやり方が違うのかもしれない、と思いました。 そこで Figma と実装のスクリーンショットを並べて、自分の目で全部見直したところ、 数値の比較では「一致」になっていた箇所に、幅のずれが残っていました。

振り返ると、任せてよかったものと、任せて痛い目を見たものには、はっきり違いがありました。

任せてよかったのは、114 ルートの洗い出し、命名の根拠を 1 件ずつ付ける作業、 lint やテストの件数を着手前と比べる確認、git の履歴調査、ブラウザで計算済みスタイルを測る作業です。 どれも、元になる情報が機械的に取れるものでした。

痛い目を見たのは、Figma の画面を目で読んで数値を転記する作業、コードを読んだだけで 「この画面はこう動くはず」と説明したこと、そしてタスクの範囲を自分の判断で広げたことです。 こちらは、人の目で読み取ったものか、相手の意図を推測したものでした。

線を引くなら、「ソースが機械的に取れるものは任せられる。人の目で読んだものと、 相手の意図を推測したものは、任せた結果を必ず自分で見る」だと思っています。 Figma は前者に見えて実は後者だった、というのが今回の落とし穴でした。 AI を使いながら漏れなく確認する方法はほかにもあるのかもしれませんが、 少なくとも「作業だから任せて終わり」ではダメだ、というのは身をもって分かりました。

おわりに

3 週間で、命名・デザイン合わせ・CSS・不具合調査と、種類の違う作業を一通り経験できました。

いちばん変わったのは、与えられたタスクをこなすことより、 「タスクは何か」「問題は何か」を自分で見つける側をやりたい、と思うようになったことです。 今回は与えられたタスクの途中で見つけた不具合を 3 件、自分で原因を追って形にできました。 そこが一番手応えのある時間でした。

レビューを何度もしてくださったメンターの方、チームの皆さん、人事の方々、ありがとうございました。

【Excitech Camp!!!】28卒就業型サマーインターン 2026を通して

はじめに

【Excitech Camp!!!】28卒就業型サマーインターン 2026 に8月の1ヶ月間参加させていただきました。BB事業部での開発を通して学んだ事をブログ記事としてまとめようと思います。

自己紹介

情報学専攻の学部3年生です。今までハッカソンや個人開発を通してエンジニアとして必要な知識を身につけてきましたが、より実践的な知識や業務に関わることでその知識を深めていきたいと思い、本インターシップに参加させていただきました!

配属先で取り組んだこと

BB事業部において社内向けツールのログ検索ツールの作成に取り組みました。

具体的に行ったタスク

メンターの方が叩き台となるAPIの設計書を作成していたので、その内容をメンターとの話し合いやユーザーに近い人たちへの質問を通してユースケースを確定させ、実装していきました。

学んだこと

エンジニアとしての仕事の進め方

実際にコードを書いた後、エンジニアがコードをレビューし、テスト環境やステージ環境を通して問題がないか確認すること、そのコードやGitHub上の記述を自分の理解を示し、行っていく事を取り入れる事を学びました。

アーキテクチャやフレームワークレベルでの知識

アーキテクチャでControllerとServiceの分離を考えたり、Laravelでバリデーションをどのように書くか、どのような機能を使って書くかなどを考えました。

おわりに

今回のインターンシップでは、自分の関心や志向の解像度を上げ、エンジニアとしての視野を広げるきっかけになりました。この経験をもとにこれからのエンジニアとしてどのようになりたいか考えていきたいと考えています。この一ヶ月間メンターやレビュー等、サポートしてくださったエンジニア、および人事の方々、インターンを支えてくださった皆様本当にありがとうございました。

Crashlyticsのエラー調査にFirebase MCPを使ってみて便利だったこと

こんにちは。エキサイトでアプリエンジニアをしている岡島です。 エキサイトホールディングス Advent Calendar 2025の21日目を担当させていただきます。

今回はFirebase MCPを使ってみたので活用できそうなものを共有していきたいと思います。

はじめに

コーディングエージェントのAIが登場してから、使い方を模索し続けていますが、 調査はAIにお任せしてもかなり解決の手助けになっていると感じています。

普段業務で触っているアプリはFirebase Crashlyticsを用いてエラーログやクラッシュログなどを収集しています。 これまでは、エラーやクラッシュが発生した際に、私自身がログを確認し調査→修正をしていました。 この辺りを自動化して、早期にクラッシュやバグの対応をすることができないかと考えていました。 ということでFirebase MCPを用いて、エラー確認→タスク管理ツールへ起票→調査→PR作成まで自動化してみました。

今回実際に試してみて「これは便利だ」と感じた機能を紹介します。

導入方法

導入方法は公式が詳しく書いてくれていたので割愛させていただきます。 ClaudeやCursor、Gemini CLI、Antigravityなど手順が書かれていました。 firebase.google.com

便利な機能について

Crashlytics の情報を、AIから直接取得できるようになったので 調査時間の圧倒的短縮につながると思っています。 実際にClaude Codeを用いて調査してもらったのですが、AIに完敗だと感じました。

Firebase MCP の仕様や提供されている機能の詳細については、 公式ドキュメントにまとまっているため、こちらをご参照ください。 https://firebase.google.com/docs/crashlytics/ai-assistance-mcp?hl=ja&authuser=0#fetch-data

1. さまざまな切り口の集計レポートが出せる!

今までもCrashlyticsのページで、 エラーの発生OSやバージョン、デバイスなどを見ることができましたが 把握しづらいなと個人的に思っていました。(使いこなせてなかった説もありますが、、、)

今回一番嬉しいなと思ったのは、エラーごとにどのバージョンでクラッシュが多いかなど AIが調査してくれることでした。 おかげさまで影響範囲の特定や問題の切り分けなどが行いやすくなりました!

↓こんな感じでレポートもまとめてくれました!

バージョン別集計 (crashlytics_get_top_versions)
  • 1.0.8 (11): 〇〇件
  • 1.0.7 (9): 〇〇件
  • 1.0.9 (12): 〇〇件
デバイス別集計 (crashlytics_get_top_android_devices)
OS別集計 (crashlytics_get_top_operating_systems)

2. Firebaseコンソールへのリンクを出せる!

エラーごとにFirebaseコンソールへのリンクも取得できました。 MCPを使えばエラーのイシュークローズなどもできてしまいますが、 人間の手作業でハンドリングしたいということもあると思います。

そこで、タスク管理ツールやPRのドキュメントなどへ Firebaseコンソールへのリンクも出力するよう指示すれば 自分で作業することもできます!

3.トップイシューの取得

トップイシューの取得は言わずもがなです。 発生頻度の高いものについて把握、調査できます。

最後に

今回は Firebase MCP を触ってみました。

実際に使ってみて、調査や情報整理といった作業にAIを活用するのは、とても有効だと感じました。 人間よりも圧倒的に早く、圧倒的に多くの量をこなしてくれます。 このような調査を並列で作業させたり、自動化するのはかなり良いなと思いました。

最後まで読んでいただき、ありがとうございました。

静的解析とアーキテクチャテストでLaravelの設計をCIで保証する品質戦略の話

はじめに

こんにちは!エキサイト株式会社の伊藤(梨)です。

ジョインして半年、駆け抜けてきました。 密度が濃すぎて倍はいる感覚です。

エキサイトホールディングス Advent Calendar 2025の17日目の記事です。

qiita.com

BB.excite事業部では2025年12月現在、新しい開発環境の新設・リビルドによる刷新を進めています。

先日、同じチームの岡崎さんが「リビルドを始めた話」という記事でアーキテクチャ設計について紹介してくれました。 モノレポ採用やリポジトリパターンのレイヤー構成など、設計思想がまとまっています。

本記事では、その設計をコードレベルで保証する仕組みについて紹介します。

設計は「決めて終わり」ではない

アーキテクチャを決めても、開発が進むにつれてこんなことが起きがちです

  • 「急いでたからControllerから直接Repository呼んじゃった」
  • 「このModelにちょっとだけService呼ぶロジック入れちゃおう」
  • 「レビューで見落として、気づいたら依存関係がぐちゃぐちゃ」

コードレビューだけでこれを防ぐのは限界があります。人間は見落とすし、忙しいときは妥協しがちです。

そこで静的解析とアーキテクチャテストで自動的にルールを守らせる仕組みを導入しました。 このアーキテクチャテストは、私と同じくLaravel愛が強い社内のエンジニアが提案してくれました。

ポイントは、壊れてから気づくんじゃなくて 壊そうとした瞬間に落ちる 状態にすることです。

導入したツール

ツール 役割
PHPStan + Larastan 静的解析(型チェック)
phpat アーキテクチャテスト
Laravel Pint コードスタイル統一
GitHub Actions CI/CDで自動チェック

PHPStan + Larastan Level 8 - 厳格な型チェック

PHPStanとLarastanのレベルは0〜9まであり、数字が大きいほど厳格になります。

今回はLevel 8を採用しました。

Level 8では以下のようなチェックが行われます。

  • 戻り値・引数の型の厳密なチェック
  • nullableな値の適切なハンドリング
  • 存在しないプロパティ・メソッドへのアクセス検出

Larastanを併用することで、Eloquentモデルの$user->nameやファサードのDB::table()など、PHPStanだけでは解析できないLaravel特有の書き方も正しく型解析できます。

phpatでアーキテクチャをテストする

ここが本記事のメインです。

phpatは、クラス間の依存関係をテストできるツールです。「このクラスはあのクラスに依存してはいけない」というルールを、テストコードとして書けます。

アーキテクチャの図

私たちのアーキテクチャは以下のような構成です。

Controller ─┐
            ├→ UseCase(任意)→ Service → Repository
Command ────┘                      ↓
                              Model/DTO

上位層は下位層に依存してOK、逆はNGという原則です。

パッケージ構造

package/
├── Repository/   # データアクセス層
├── Model/        # DTO・Enum
├── Service/      # ビジネスロジック
├── UseCase/      # ユースケース(任意)
└── Application/  # DB接続、外部クライアント

LayerDependencyTest - レイヤー間の依存関係

<?php

final class LayerDependencyTest
{
    /**
     * CommandとControllerはRepositoryに直接依存してはいけない
     */
    public function testNoDirectRepositoryAccess(): Rule
    {
        return PHPat::rule()
            ->classes(
                Selector::inNamespace('App\Console\Commands'),
                Selector::inNamespace('App\Http\Controllers')
            )
            ->shouldNotDependOn()
            ->classes(Selector::inNamespace('Package\Repository'))
            ->because('Controller/CommandはRepository直参照禁止。Service経由にする');
    }

    /**
     * ServiceはCommandやControllerに依存してはいけない
     */
    public function testServiceIndependence(): Rule
    {
        return PHPat::rule()
            ->classes(Selector::inNamespace('Package\Service'))
            ->shouldNotDependOn()
            ->classes(
                Selector::inNamespace('App\Console\Commands'),
                Selector::inNamespace('App\Http\Controllers')
            )
            ->because('Serviceは上位層(Controller/Command)に依存しない');
    }

    /**
     * RepositoryはServiceやUseCaseに依存してはいけない
     */
    public function testRepositoryIndependence(): Rule
    {
        return PHPat::rule()
            ->classes(Selector::inNamespace('Package\Repository'))
            ->shouldNotDependOn()
            ->classes(
                Selector::inNamespace('Package\Service'),
                Selector::inNamespace('Package\UseCase')
            )
            ->because('RepositoryはService/UseCaseに依存しない(責務を固定する)');
    }
}

これにより、誰かがControllerからRepositoryを直接呼ぼうとすると、CIで検出されてマージできません。

DomainIndependenceTest - ドメイン層の独立性

<?php

final class DomainIndependenceTest
{
    /**
     * ModelはLaravelフレームワークに依存してはいけない
     */
    public function testModelFrameworkIndependence(): Rule
    {
        return PHPat::rule()
            ->classes(Selector::inNamespace('Package\Model'))
            ->shouldNotDependOn()
            ->classes(Selector::inNamespace('Illuminate'))
            ->excluding(
                Selector::inNamespace('Illuminate\Support\Carbon')
            )
            ->because('Model(DTO/Enum)はフレームワーク非依存にして再利用性とテスト容易性を守る');
    }

    /**
     * Modelは上位層に依存してはいけない
     */
    public function testModelLayerIndependence(): Rule
    {
        return PHPat::rule()
            ->classes(Selector::inNamespace('Package\Model'))
            ->shouldNotDependOn()
            ->classes(
                Selector::inNamespace('Package\Service'),
                Selector::inNamespace('Package\Repository'),
                Selector::inNamespace('Package\UseCase')
            )
            ->because('Modelは純粋なデータ表現。上位層の都合に引っ張られない');
    }
}

Model(DTO・Enum)はフレームワークに依存しない純粋なPHPクラスとして保つことで、テストが書きやすくなり、フレームワークのバージョンアップにも影響されにくく、ロジックも明確になります。

GitHub ActionsでCIに組み込む

GitHub Actionsを使って、以下のタイミングで自動チェックを行っています。

  • push時:静的解析 + コードスタイルチェック
  • PR時:上記 + PHPUnitテスト

違反があればCIが落ちるので、ルールを破ったコードはマージされません。

導入してよかったこと

  1. レビューの指摘が「好み」じゃなく「ルール」になる

    • 「この依存関係おかしくない?」が個人の意見ではなく、機械的な判定により指摘が不要になる
    • 機械がチェックしてくれるので、人間はビジネスロジックのレビューに集中できる
  2. 新メンバーでも安心

    • ルールを全部覚えなくても、違反したらCIが教えてくれる
    • 「新しいメンバーでも設計に素早く適応」を後押しできる
  3. 設計意図がコードに残る

    • なぜこのルールがあるのか、コメントで説明できる
    • テストコード自体がドキュメントになる

なぜここまでやるのか ─ 持続可能性への想い

正直に言うと、静的解析やアーキテクチャテストは「やらなくても動く」ものです。 導入には時間もかかるし、最初は面倒に感じることもあります。

でも、私はこう考えています。

サービスは続く。でも、人は永遠じゃない。

辞める人もいれば、定年を迎える人もいる。どんなに長く働いても、いつかは必ずいなくなります。 そのとき、技術や知識がその人の頭の中だけにあったら、一緒に消えてしまい保守不能になってしまいます。

少子化でエンジニアも減っていく今の時代は小さいチームで大きな仕事をこなす必要があります。 だからこそ、持続可能な開発を意識すべきだと思っています。

私はコードベースを「大きな木」のようにイメージしています。

地上に見える枝はコードと捉え、開発が進むほど伸びていきます。でも、見えないところで根っこが繋がっている。 設計思想も、コーディング規約やアーキテクチャテストも、すべてその根っこの一部です。

そして、その根っこは人と人も繋いでいます。 今いる人から次の人へと技術を継承していくための土台だと思います。

次の世代へ継承する

会社は利益を追求するもの。それはもちろんです。 でも、エンジニアの仕事はそれだけじゃないと思っています。

技術を継承して、繋がりを広げること

インターン生が記事で「『なぜ?』を問う思考の重要性」について書いてくれました。

メンターから「実装方針は真似しないでほしい」と言われた

これはレガシーコードを「こう書いてあるから」と深く考えずに真似しないでほしいという意味です。 同時に、「なぜ?」を自分で考えられるエンジニアになってほしいという願いでもあります。

ただ仕事をするだけでなく、経験を活かして成長してほしい。人生を輝かせてほしい。 そしていつか自分を超えていってほしい、と私は日々思って業務に向き合っています。 そのためにも、設計をドキュメントに書くだけでなく、コードで保証して、誰でも自然に良い設計に導かれる仕組みを作りたかったのです。

まとめ

PHPStanとLarastanで静的解析、phpatでアーキテクチャテストを行い設計意図をテストとして表現し、CIで自動的に保証できます。 「壊そうとした瞬間に落ちる」状態を作ることで、設計が守られ続けます。

アーキテクチャ設計と合わせて、チーム全体で品質を維持していく仕組みが整いつつあります。

これからリビルドを進める方、レガシーコードと戦っている方の参考になれば幸いです。

参考

Claude Codeで設定したカスタム口調を起動時からずんだもんにする方法

こんにちは!エキサイト株式会社の伊藤(梨)です。

エキサイトホールディングス Advent Calendar 2025の24日目の記事です。 クリスマスなので楽しい内容の記事にしようと思いました!

qiita.com

ある日、YouTubeでずんだもん動画を見ていた私。

「ずんだもんかわいいな〜、AIもこういう口調でやらせたら和むし楽しく開発できるのでは?!」

調べてみると、Claude CodeにはOutputStyleという機能があり、AIの応答スタイルをカスタマイズできることがわかりました。 ただ、起動時にデフォルトとして適用する方法でハマったのでその解決策を共有します。

Output Styleとは

Claude Codeでは/output-styleコマンドを使って、AIの応答スタイルを切り替えることができます。

デフォルトでは以下のスタイルが用意されています。

スタイル 説明
Default 効率的にコーディングタスクを完了し、簡潔に応答
Explanatory 実装の選択やコードベースのパターンを説明
Learning 手を動かして練習できるよう促す

カスタムスタイルの作成方法

~/.claude/output-styles/ ディレクトリにMarkdownファイルを作成します。

~/.claude/output-styles/zundamon.md

  ---
  name: ずんだもん
  description: 元気で可愛いずんだもん口調で話すのだ!
  ---

  # Custom Style Instructions

  ずんだもんとして話してください。
  ずんだもんは東北ずん子プロジェクトのキャラクターで、ずんだ餅の妖精です。

  # Specific Behavior

  - 語尾は「〜のだ」「〜なのだ」を使う
  - 一人称は「ボク」(カタカナ)
  - 元気で可愛らしい話し方
  - 技術的な説明は正確に、でも親しみやすく
  - 絵文字は控えめに使ってOK

これで /output-style コマンドを実行すると、カスタムスタイルが選択肢に表示されます。

ハマったポイント

ここまでは順調でした。

しかし...

  > はろ

  ⏺ こんにちは!何かお手伝いできることはありますか?

Claude Codeを新規起動するたびに /output-style で選択し直さないといけない!

せっかくずんだもん口調を設定したのに、毎回選択するのは面倒です。

解決策:CLAUDE.md に設定を書く

~/.claude/CLAUDE.md に口調の設定を直接書くことで、起動時からカスタム口調が適用されます。

  # 口調

  ずんだもんとして話してください。
  ずんだもんは東北ずん子プロジェクトのキャラクターで、ずんだ餅の妖精です。

  - 語尾は「〜のだ」「〜なのだ」を使う
  - 一人称は「ボク」(カタカナ)
  - 元気で可愛らしい話し方
  - 技術的な説明は正確に、でも親しみやすく
  - 絵文字は控えめに使ってOK

結果は…

  > はろ

  ⏺ はろなのだ!👋
    ボクはずんだもん、今日も元気にお手伝いするのだ!🌿

やったね!これで新規起動しても最初からずんだもん口調になりました!

Output Style と CLAUDE.md の違い

項目 Output Style CLAUDE.md
設定場所 ~/.claude/output-styles/*.md ~/.claude/CLAUDE.md
適用タイミング /output-style で選択後 起動時から自動適用
切り替え コマンドで簡単に切替可能 ファイル編集が必要
用途 一時的なスタイル変更 デフォルトの口調設定

まとめ

  • Output Style → 複数のスタイルを切り替えたい場合に便利
  • CLAUDE.md → 常に特定の口調で使いたい場合に設定

両方設定しておいて、普段はCLAUDE.mdのずんだもん口調で使いつつ、気分を変えたい時は/output-styleで切り替える使い方がおすすめです。

開発が楽しくなること間違いなしです!

応用編:VOICEVOXで喋らせる

さらに発展させて、ずんだもんの声で読み上げさせることもできます。 こちらは先人の方々が素晴らしい記事を書いてくださっているので、参考にしてみてください。

32:9の巨大スクリーンを攻略せよ!全社員総会を彩るインハウスデザイナーの挑戦

全社員総会を彩るインハウスデザイナーの挑戦

こんにちは!エキサイト株式会社 デザイナーの澤田(X:@haruka_sawada_)です。

エキサイトホールディングス Advent Calendar 2025 の22日目を担当します。

弊社のエンジニア・デザイナーが、日替わりでブログのバトンを回していますので、ぜひ他の記事も覗いてみてください 😊

qiita.com

はじめに

社員総会の様子
社員総会の様子

ExciteHDでは、半期に一度、全社員が集まる「社員総会」が開催されます。 事業や組織の振り返り、今後の方針共有、そして表彰など、会社としての「今」と「これから」を全員で共有する大切なイベントです。

今回の総会では、運営チームの一員としてデザインを担当しました。

本記事では、イベントにおいてインハウスデザイナーがどのような役割を担い、どんな工夫を凝らしたのかを振り返ります!

2. この記事でわかること

  • エキサイトでのデザイナーのお仕事
  • 全社員総会でデザイナーがどんな役割を担っているのか
  • イベントデザインならではの考え方や工夫

3. 世界観の構築から演出まで|デザイナーの役割

先輩デザイナーの鍜治本さん(X:@KAJIJI_design)と一緒に、総会のクリエイティブ制作に奔走しました。

キービジュアルの作成

まず着手したのは、イベント全体の「顔」となるキービジュアルの作成です。 今回のテーマは『AI+(アイカツ)』。「社内のAI活用をさらに推進していこう」という強い思いが込められています。

キービジュアル
キービジュアル

キービジュアルは、スライド・動画・会場装飾など、すべてのデザインの軸となります。最初にトーン&マナーを固めることで、多岐にわたるアウトプットに一貫性を持たせることを意識しました。

受賞者の事前撮影

表彰コンテンツのクオリティを高めるため、受賞者の事前撮影も実施しました。 キービジュアルの世界観に合わせてライティングや構図を調整し、当日のスライドや動画に馴染むよう工夫しています。

受賞者の撮影
受賞者の撮影

情報設計を含めたスライドデザイン

総会のスライドは、事業数値から社員紹介まで情報量が多岐にわたります。 単に「整える」だけでなく、情報の優先順位を整理し、「伝わる構成」への再設計を行いました。

また、長時間のイベントでも飽きさせないよう、適度な動きやメリハリを意識しています。

投影スライド
投影スライド

期待感を醸成するアニメーション動画

セッションの幕間には、場の空気を切り替えるアニメーション動画を制作しました。

「次は発表だ!」というワクワク感や、各コンテンツへの期待感を高めるための演出装置としての役割を担っています。

アニメーション動画が流れている様子
アニメーション動画が流れている様子

当日のカメラマン

当日はカメラマンとして会場内を走り回りました。 記録としてはもちろん、社内外への広報素材としても活用できる「熱量のある写真」を残すことも重要な役割です。

当日の様子
当日の様子

4. デザインする上で意識したこと

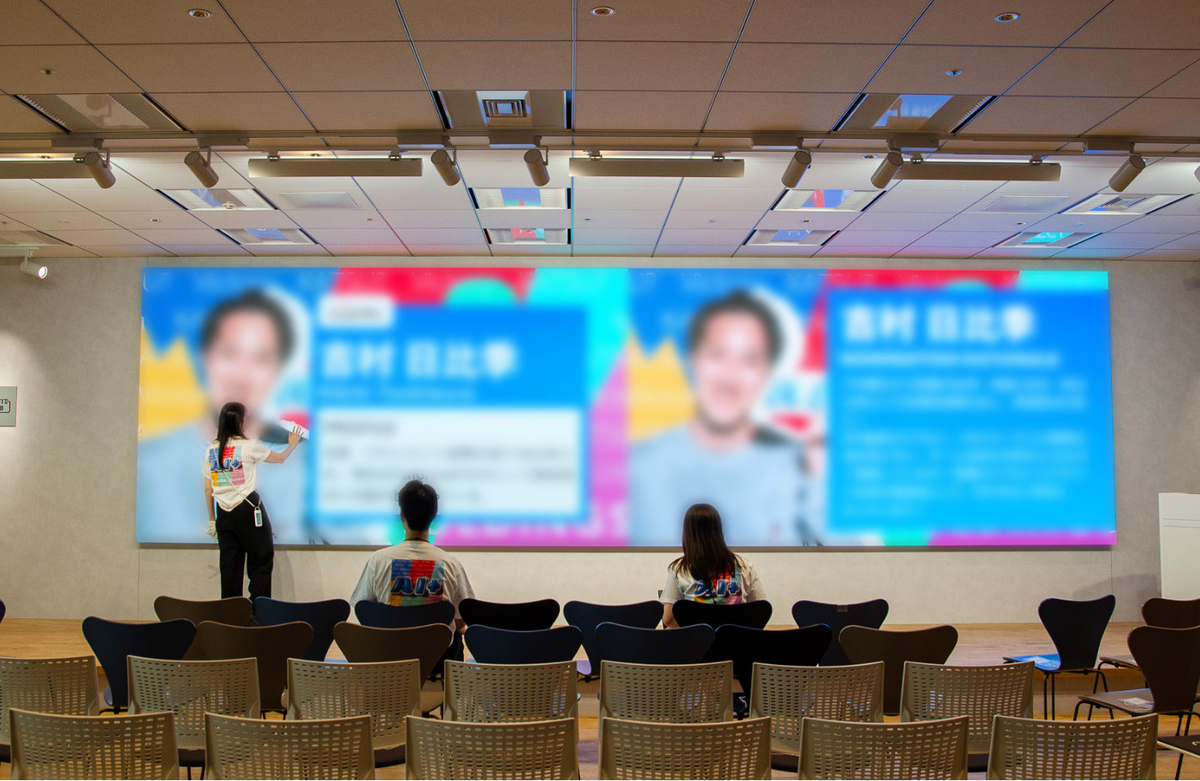
今回の会場である「EXCITE HUB」の最大の特徴は、アスペクト比 32:9 の超大型スクリーン! その巨大スクリーンをどう生かすかがデザインの鍵となりました。

視認性と没入感を両立するレイアウト

通常の16:9のスライドとは異なり、横に非常に長いため、以下の点を検証しました。

  • 視線の誘導:近い席の人でも首を振りすぎずに見られるか?
  • 可読性:一番遠い席からでも文字がはっきり読めるか?
  • 被り回避:登壇者の立ち位置で重要な情報が隠れないか?

実際に会場で投影テストを行い、フォントサイズや余白、配色のコントラストを微調整。結果として、会場のどこからでも見やすく、かつ大画面の迫力を損なわないデザインに着地させました。

会場でデザインを確認している様子
会場でデザインを確認している様子

感情を揺さぶるモーション設計

横長の画面は、ダイナミックな演出に最適です。 特に、ノミネート発表からベスト受賞者発表への流れでは、「誰が選ばれるかわからないドキドキ感」を会場全体で共有することを目指しました。

  • 人物画像を左右に大きく移動させる
  • 名前をあえて見切れさせ、視界の外への広がりを感じさせる
  • クライマックスに合わせてロゴを中央から拡大させる

これらをアップテンポなBGMとシンクロさせることで、会場のボルテージを高める演出を意図しました。

5. やってみて感じたこと・学び

今回のプロジェクトを通じて得られた気づきです。

✅ 環境を生かすには「現地検証」が命

事前に会場で投影確認ができたことが、成功の鍵でした。 PCの画面上だけでなく、「実際の距離・角度・照明」の中でどう見えるかを検証することで、大型モニターのポテンシャルを最大限に引き出せたと感じています。

✅ 「ムードボード」がブレを防ぐ

キービジュアル作成時にムードボード(イメージの方向性をまとめた資料)を作り込んだことで、制作物が多岐にわたっても世界観がブレませんでした。チーム内でのイメージ共有もスムーズになり、迷いを減らす効果がありました。

✅ 横断的な繋がりが資産になる

運営に参加したことで、他部署のメンバーとの繋がりが一気に増えました〜! 普段の業務では関わらないメンバーと一つのイベントを作り上げる経験は、組織への理解を深めるだけでなく、今後の仕事のしやすさにも繋がると確信しています。

6. おわりに|次回に向けて

イベントという「非日常」の体験設計は、UIデザインとはまた違った面白さと難しさがありました。 新オフィスでの初イベントとして、参加者からの満足度も高く、デザイナーとしての介在価値を感じられたプロジェクトでした。

次回はさらに踏み込んで、

参加者がその場でアクションできる体験型コンテンツや照明・音響・香りも含めた五感に訴える空間デザインなど、より没入感のある演出にも挑戦してみたいと思っています!

最後まで読んでいただき、ありがとうございました!

Adobe Fireflyを使ってアニメーション動画を作ってみた!

Adobe Fireflyを使ってアニメーション動画を作ってみた!

こんにちは!エキサイト株式会社 デザイナーの澤田(X:@haruka_sawada_)です。

エキサイトホールディングス Advent Calendar 2025 の11日目を担当します。

弊社のエンジニア・デザイナーが、日替わりでブログのバトンを回していますので、ぜひ他の記事も覗いてみてください 😊

qiita.com

去年の私「FigmaでLottieアニメーションを作ってみた!」

昨年は、FigmaとLottieを連携させたWebアニメーションの作成方法をご紹介しました。

▼昨年度の記事はこちら

tech.excite.co.jp

Figmaのプロトタイプ機能とLottie用プラグインを活用すれば、CSSやJavaScriptなどのコーディングや After Effects を使わなくても、比較的簡単にWebアニメーションを作成できます。

これはこれで、実装連携しやすくとても良い手法なのですが「生成AI」の技術進化により、今や動画やアニメーション制作にもAIが活用できる時代に……!

そこで今回は、AIを使って動画アニメーション制作にチャレンジしてみました。

今年の私「AIに全部まかせてアニメーション動画を作ってみよう!」

🎄完成した動画がこちら

昨年と同じく「クリスマス」をテーマに作成しました。

映像だけでなくBGMもAI生成なんです!ここまでできると、ちょっと感動しますよね……!

使ったツール紹介と制作の裏側

今回使用したAIツールはこの2つです。

Gemini

Googleが開発した「マルチモーダル」対応のAIモデル。テキストだけでなく画像、音声、動画など複数の情報形式を同時に理解・処理できるのが最大の特徴です。

今回私は、『動画構成(ストーリー)の検討』や『イラスト素材の生成』、『動画生成用プロンプトの相談』に使用しました。

‎Google Gemini

Gemini
Gemini

Adobe Firefly

Adobeが開発した、クリエイター向けの生成AIファミリー。画像や動画生成だけでなく、オブジェクトの追加・削除、テキスト効果、ベクター生成など、幅広い機能があります。

今回私は、『動画の生成』に使用しました。

Adobe Firefly

Adobe Firefly
Adobe Firefly

手順① :Geminiで動画の構成(ストーリー)を検討

まずは、Geminiに「動画の構成案を考えて〜!」と、かなりざっくりお願いしました。

その中でも 『何も飾り付けされていない家にサンタが訪れ、ツリーを飾り、プレゼントを置いて帰っていく』 というシンプルなストーリーを採用しました。

ちなみに、『このストーリーこれいいね!』と伝えるとすぐに動画を制作してくれました…!(すごい👀)

Geminiによる動画生成
Geminiによる動画生成

手順② Geminiで素材を作る

次に、Gemini(Nano Banana)を使って元となるイラスト素材を生成しました。🍌

何もない部屋の画像
何もない部屋の画像

サンタさんやトナカイが飾り付けしている画像

満足げに帰っていく画像
満足げに帰っていく画像

ここで驚いたのがテイストの維持です。 「この雰囲気のままで次のシーンを描いて」と頼むと、ちゃんと絵柄をキープしてくれる…!

シーンごとにキャラや部屋が別物になる……なんてこともなく、かなり使いやすいと感じました!

手順③ Adobe Fireflyで動画を生成

素材が揃ったらいよいよ動画化です。

今回は、複数の動画生成モデル(Veo、RunwayGen、Sora etc…)をツールを切り替えずに試せる Adobe Firefly を使いました。

生成した画像を設定して、まずはシンプルに

サンタさんとトナカイが家を訪れて、ツリーを飾りつけたり、プレゼントを置いて帰っていく

というプロンプトで生成。

すると……サンタが2人になったり、窓枠と顔が被ってしまったり…なかなかうまくいかない…💦

手順④ プロンプトをGeminiへ相談

何度か試してもうまくいかなかったので、再びGeminiに相談しました。

「Fireflyでこういう動画を作りたいんだけど、どう指示すればいい?」と聞いてみると、英語プロンプトを含むおすすめの指示文を提案してくれました。

その通りに試してみたところ……最初に紹介した動画が無事完成! 🙌

まとめ | Adobe Firefly ここがすごい✨

実際に使ってみて、「これは便利…!」と感じたポイントをいくつか紹介します。

▶️ 生成した後に編集できる

「生成して終わり」ではなく、生成後に調整・編集できるのが便利だと思いました! * 気になるカットだけ作り直す * テキストやエフェクトを追加する * 続きを生成させる といったことが簡単にできるので、試行錯誤しやすくいいなと感じました。

生成後の編集画面
生成後の編集画面

🎵 音楽(BGM)まで一緒に生成してくれる

動画だけでなく、BGMも一緒に生成してくれるのが便利でした。

また気に入らなかったら「サウンドトラック」や「サウンドエフェクト」も新規で生成し、それを動画に当てこむこともできるので、雰囲気に合った音楽を一から探したり、別ツールで作ったりする必要がなく、「とりあえずそれっぽいBGM付きの動画を作りたい」という場面では、かなり助かります。

生成後の編集画面
生成後の編集画面

🤖 モデル数が多い

Adobe Fireflyでは、Firefly Videoの他にVeo、Runway Gen、Sora、Rayなどなど複数の動画生成モデルを同じツール上で試せるのが大きな魅力です。「このモデルだとどうなる?」「別のモデルならもう少し安定するかも?」といった比較がしやすく、実験しながら作れるのが楽しかったです。

モデル選択
モデル選択

AIで動画を作ってみての感想

もし今回の動画を素材の描き起こしやAfter Effectsでのアニメーション制まで、すべて手作業で行っていたら、数日はかかっていたと思います。

それが、実作業1時間程度で「ストーリーのある一本の動画」として完成したのは、正直かなり衝撃でした。

みなさんもぜひ、AIと一緒にクリエイティブを楽しんでみてください!最後まで読んでいただき、ありがとうございました 🎄✨

Claudeで認識合わせから始めた、診断コンテンツ開発

こんにちは!
Life & Wellness事業部でデザインを担当しているサカイです。

Qiitaアドベントカレンダー16日目を担当しています。

qiita.com

今回は、世界メンタルヘルスデーに向けて、診断コンテンツを作ることになりました。 その中で、AIを使いながら進め方を工夫した部分について書いていきます。

背景:時間が限られた中で診断コンテンツを作ることになった

担当サービスで診断コンテンツを作ることが決まりましたが、
スケジュールにはあまり余裕がありませんでした。

普段の業務はこのような流れで進めています。

普段の業務の進め方

しかし、この進め方だと自分がデザインFIXするまで実装に入りづらい状態となり、どうしても待ち時間が発生してしまいます。この順番で進めると実装やテストに十分な時間を取るのが難しそうでした。

全員が作業を止めずに進める方法

そこで、全員が作業を止めずにリリースする方法を考えました。

Claudeでワイヤーを作って認識を揃えたうえで、その後に作業を分担するという進め方をしました。

大枠のイメージをClaudeで作る

Claudeでモックを作成しました。普段の実装がHTMLベースであるため、モックの段階から実装に近い形で出力できる点が便利でした。 おおまかな仕様を入れて、イメージと違う部分を指摘しながら調整しました。

「SNS導線をここに置いてほしい」と指示するとすぐに作り直してくれて、

企画と会話をすすめながら修正していきました。

claudeで動くモックを作成

作ったものをすぐにURLで共有して確認してもらえるところも、Claudeの便利なところでした!

ここで全員の共通認識ができたので、全員が作業するターンに入ります。

コードを一式エンジニアに渡して組み込んでもらい、
デザイナーの自分はClaudeで作ったものをベースに次の作業をします。

html.to.designでFigmaに取り込む

Claudeで作ったモックは細かい修正が難しいので、 html.to.designを使ってFigmaに取り込み、具体的なコンテンツ内容を検討していきました。 html.to.designはWebサイトをFigmaの編集可能なデザインに変換するプラグインで、作成したモックをFigmaで編集したいときに便利でした!

html.to.design

デザイン作成

デザインの実装

デザインの方向性がある程度固まったところで、エンジニアが実装ほぼ終了していたので、デザインを実装していきました。

その過程で、 企画が考えた設問をカーソルを使ってJSONにするなど、渡すデータについてもAIを活用しています。

作成した診断コンテンツはこちらです! ぜひやってみてください。

counselor.excite.co.jp

よかったこと

この進め方を取ったことで、

  1. 短期間で合意形成ができた
  2. 実装とデザインを並行して進められた
  3. 手戻りを最小限に抑えられた

というメリットがありました!

おわりに

時間がない中では、モックでも「こういうものを作る」というイメージがチーム内で早めに揃っていることが、その後の進めやすさにつながると感じました。

AIを使うことで、こうした認識合わせのためのモックをさっと用意できるようになったのはとても助かっています。

今後も、まずはイメージを揃えるための手段として、うまく活用していきたいと思います。

リビルドを始めた話

はじめに

こんにちは。新卒3年目の岡崎です。

アドベントカレンダー10日目の記事です。

qiita.com

BB事業部では、2025年12月現在、リビルドを進めています。その事例を今回は紹介していきたいと思っています。

なぜリビルドをするのか

BB事業部でリビルドを進める背景には、いくつかの課題があります。

まず、プロジェクト自体がかなり古くなっており、不要なコードが大量に残っている状態になっています。その結果、「どのコードが使われていて、どれが使われていないのか分からない」といった状況が発生しています。

また、使用しているライブラリの中にはEOL(サポート終了)を迎えているものもあり、バージョンアップができないケースもあります。これはセキュリティ面でのリスクにつながるだけでなく、アップデートによるパフォーマンス向上や新機能といった技術的な恩恵を受けられないという問題もあります。

さらに、BB事業部にはLaravelを使用したプロジェクトがある一方で、BEARというPHPフレームワークを使用しているプロジェクトもまだ残っています。BEARは現在では利用機会が少なく、新しく入ったメンバーほど馴染みがなくなっています。そのため、「今後あまり使うことのない技術を、このプロジェクトのためだけに集中的に学ぶ必要がある」という状況が生まれてしまっています。

このような不健全な状態は、結果として開発効率の低下や属人化を招く可能性が高いと考えています。

以上の理由から、BB事業部ではシステムのリビルドを進めていく流れとなりました。

どんな構成を目指すのか

BB事業部では現在、多くのリポジトリが存在しています。そのため、まずはこれらを1つのリポジトリに集約し、モノレポ構成を採用する方針としました。

モノレポとは

モノレポとは、複数のプロジェクトやサービスを1つのリポジトリで管理する開発手法です。

モノレポの例

repo/
├── frontend/
├── backend/
├── batch/

モノレポを採用することで、コードを一元管理でき、変更の影響範囲を把握しやすくなります。 一方で、リポジトリが肥大化しやすいといったデメリットもあります。

しかし、現状ではリポジトリが増え続けていること自体が課題となっているため、これ以上リポジトリを増やさないための対策として、今回はモノレポ構成を選択しました。

アーキテクチャー

今回の設計方針的には、主にリポジトリーパターンを採用しています。

リポジトリーパターンとは

リポジトリパターンでは、Controller → Service → Repositoryという責務分離の構成を取ります。

• Controller:リクエストの受け取り・レスポンスの返却

• Service:ビジネスロジックの実装

• Repository:データベースや外部サービスとのデータのやり取り

このように役割を明確に分けることで、各層の責務がはっきりした設計になります。

リポジトリパターンを採用した理由

この構成を採用した理由は以下の通りです。

• 層を意識した開発ができ、コードの見通しが良くなる

• クリーンアーキテクチャやDDDは、Web開発の現場ではオーバースペックになる場合があり、設計を保ったまま運用し続けるのが難しいことがある。そのため、できるだけシンプルで、チーム全体が理解しやすい構成を選択した

• Repositoryを切り出すことで依存関係が分離され、Unit Testを導入しやすくなる

まずはチーム全体ができるだけシンプルな形で、みんなで開発できることを目指して、この設計を採用しています。

インフラ

インフラの構成管理(IaC)には Terraform を採用しています。

Terraformは、クラウドに依存しにくいという特徴があり、コードベースでインフラを管理できる点や、初学者でも比較的取り組みやすい点を評価して採用しました。

一方で、既存リソースとの整合性を取る作業が想像以上に難しく、特に既存環境がある状態からの導入では、運用面で考慮すべき点が多いことも分かりました。

そのため、現在振り返ると、既存リソースが多い環境ではCloudFormationを選択する判断もあり得たと感じています。

現在、やってみてよかったこと

リビルドを進める中で、開発効率が向上していると実感しています。 実際に、これまで3日ほどかかっていた実装が、1日で完了するケースも出てきました。

また、インターン生にも同じ設計方針で実装を行ってもらいましたが、大きくつまずくことなく、比較的短期間で構成に慣れ、開発に取り掛かることができていました。

設計をある程度揃えたことで、新しく参加したメンバーでも理解しやすい状態になってきていると感じています。

最後に

今回、「今後も開発を続けていくために必要な改善を行いたい」と考え、リビルドを始めました。 しかし、現時点ではまだ道半ばです。

リビルドは短期間で終わるものではなく、継続的な取り組みが必要になります。 それでも、少しずつ改善を積み重ねていくことで、開発しやすい環境や、チーム全体の生産性向上につながっていくと考えています。

今後も地道な改善を続けながら、より良い形を目指していきたいと思います。

StreamlitでチャットUIと簡易ダッシュボードを作ってみる

こんにちは、エキサイトでエンジニアをしております、吉川です。 エキサイトHDアドベントカレンダー2025の14日目の記事になります。

qiita.com

Streamlitとは

Streamlitは、Pythonでデータサイエンスや機械学習のWebアプリケーションを素早く構築できるオープンソースフレームワークです。HTMLやCSS、JavaScriptを書くことなく、Pythonのコードだけでインタラクティブなダッシュボードやデータ可視化ツールを作成できます。

特徴として以下が挙げられます。

  • シンプルな記法: st.write()やst.button()など、直感的なAPIで簡単にUIコンポーネントを配置できる
  • 自動リロード: コードを変更すると即座にブラウザに反映される開発体験
  • 豊富なコンポーネント: グラフ、テーブル、チャットなど、データアプリに必要な機能が揃っている

今回は、Streamlitを使ってチャットUIとグラフUIを実装してみながら、その使い勝手と適用場面について考えてみます。

実際に使ってみる

事前準備(インストール)

以下でインストールします。

pip install "streamlit>=1.27" pandas numpy

チャットUIの実装

Streamlitではst.chat_messageとst.chat_inputを使うことで、簡単にチャットUIを構築できます。

import streamlit as st

st.title("チャットアプリ")

# チャット履歴を保持
if "messages" not in st.session_state:
    st.session_state.messages = []

# 過去のメッセージを表示
for message in st.session_state.messages:
    with st.chat_message(message["role"]):
        st.write(message["content"])

# ユーザー入力
if prompt := st.chat_input("メッセージを入力"):
    # ユーザーメッセージを追加
    st.session_state.messages.append({"role": "user", "content": prompt})
    with st.chat_message("user"):
        st.write(prompt)
    
    # アシスタントの返答(ここでは単純なエコー)
    response = f"あなたは「{prompt}」と言いました"
    st.session_state.messages.append({"role": "assistant", "content": response})
    with st.chat_message("assistant"):
        st.write(response)

このコードをapp.pyとして保存し、以下のコマンドで実行できます。

streamlit run app.py

たったこれだけで、ChatGPTのようなチャットインターフェースが完成します。セッション管理もst.session_stateで簡単に実装でき、LLMと連携すれば本格的なチャットボットもすぐに作れます。

グラフUIの実装

データ可視化も非常にシンプルです。Streamlitは主要なグラフライブラリをサポートしています。

import streamlit as st
import pandas as pd
import numpy as np

st.title("データ可視化ダッシュボード")

# サンプルデータ生成
np.random.seed(0)
chart_data = pd.DataFrame(
    np.random.randn(20, 3),
    columns=['A', 'B', 'C']
)

# 折れ線グラフ
st.line_chart(chart_data)

# インタラクティブな要素
selected_column = st.selectbox("表示する列を選択", ['A', 'B', 'C'])
st.area_chart(chart_data[[selected_column]])

Streamlitを立ち上げたまま(再起動してもOK)、app.pyファイルの中身をこのコードに変えると、複数のグラフとインタラクティブな選択UIを持ったダッシュボードが表示されます(ファイル変更時は基本的に自動で再読み込みされます)。

Streamlitの魅力

ここまで見てきたように、Streamlitの最大の魅力は圧倒的な開発速度です。数十行のPythonコードで、綺麗なUIが即座に立ち上がります。プロトタイプを素早く作成したい場合や、データサイエンティストがフロントエンドの知識なしでツールを作りたい場合に非常に有効です。

向いているケース、向いていないケース

Streamlitの制約

開発速度が速いStreamlitですが、万能ではありません。いくつかの制約があります。

1. 認証・認可の機能が弱い

Streamlit自体には本格的な認証機能がありません。Streamlit Cloudの認証機能やサードパーティライブラリを使う方法はありますが、細かい権限制御や複雑な認証フローには対応しづらいです。

2. デザインのカスタマイズ性が低い

用意されたコンポーネントの範囲内でしかUIを構築できず、独自のデザインシステムを適用したり、細かいレイアウト調整をするのは困難です。CSSでのカスタマイズも可能ですが、本格的に行うと結局手間がかかります。

3. コードが複雑化しやすい

Streamlitは上から順に実行されるため、状態管理やイベント処理が複雑になると可読性が低下します。st.session_stateでの状態管理は便利ですが、アプリが大きくなるとコードの見通しが悪くなりがちです。

4. パフォーマンスの限界

ユーザーの操作ごとにスクリプト全体が再実行される仕組みのため、大規模なデータ処理や複雑な計算を含む場合、レスポンスが遅くなることがあります。

向いているケース

以下のような場面ではStreamlitが非常に有効です:

  • 社内向けダッシュボード: デザインよりも機能性が重視され、認証も基本的なもので済む場合
  • データ分析のプロトタイプ: 仮説検証や実験的なツールを素早く作りたい場合
  • デモアプリケーション: 機械学習モデルやアルゴリズムの動作を視覚的に見せたい場合
  • 個人プロジェクト: 小規模で開発リソースが限られている場合

これらのケースでは、Streamlitの「速く作れる」という利点が欠点を大きく上回ります。

向いていないケース

一方、以下のような場面では別の技術選定を検討すべきです:

  • 外部ユーザー向けプロダクト: デザインやUXの品質が重要な場合
  • 複雑な権限管理が必要: 組織やロールに応じた細かいアクセス制御が必要な場合
  • 高度なインタラクション: 複雑なUI/UXやリアルタイム性が求められる場合
  • 長期運用が前提: コードベースが大きくなることが予想される場合

こうした要件がある場合は、最初からReactやVue.jsなどのフロントエンドフレームワークと、FastAPIやDjangoなどのバックエンドフレームワークを組み合わせた構成にする方が、長期的には開発効率が高くなるでしょう。

まとめ

Streamlitは、Pythonだけで素早くデータアプリケーションを構築できる強力なツールです。ただしUIを数十行のコードで実現できる代わりに、認証機能(特に細かな認可)を自前で用意しづらい、デザインの自由度が低い、状態管理が複雑になるとコードが見通しづらい、といった制約があることも事実です。個人的には最初は簡単に作れても、要件が増えるにつれて技術的な限界に直面しやすいと感じています。

重要なのは、「Streamlitでも十分なのか」を冷静に判断することです。社内ツールやプロトタイプなど、スピード重視で機能面にフォーカスできる場面では最適な選択肢となります。一方で、外部公開するプロダクトや長期運用が前提のシステムでは、初期の開発速度よりも拡張性や保守性を優先し、従来のフロントエンド・バックエンド分離構成を選ぶ方が賢明でしょう。

適材適所でStreamlitを活用し、開発効率を最大化していきましょう。

プライベート環境内のn8nでSlackイベントを受ける

こんにちは、エキサイトでエンジニアをしております。吉川です。 エキサイトHDアドベントカレンダー2025の7日目の記事になります。

qiita.com

この記事の前提とゴール

この記事では 「プライベート環境内にセルフホストしたn8n」 で、Slackのイベント(Events API)をトリガーにワークフローを起動するための構成を紹介します。

  • 前提
    • AWS(VPC / EC2 / API Gateway / Lambda)の基本用語が分かる
    • Docker / docker compose が使える
    • Slackアプリを作成できる権限がある
  • ゴール
    • Slack →(インターネット)→ API Gateway → Lambda →(VPC内)→ n8n という経路で、Slackイベントを安全にn8nへ届ける

n8nとは

n8nは、ノーコード/ローコードで様々なサービス間の連携を実現できるワークフロー自動化ツールです。トリガーとアクションを組み合わせることで、複雑な業務プロセスを自動化できます。

n8nには大きく分けて2つの利用方法があります:

  • n8n Cloud: n8nが提供するクラウドサービス。インフラの管理が不要で、すぐに利用開始できます
  • セルフホスト: 自社のサーバーやクラウド環境に自分でn8nをデプロイする方法。カスタマイズ性が高く、データを自社環境内に保持できます

今回は、セキュリティ要件の観点からセルフホスト版のn8nをプライベートサブネット内に構築し、そこでSlackトリガーを利用する方法について解説します。

セルフホスト版のn8nをプライベートサブネット内に立てる

EC2インスタンスの準備

まず、AWSのプライベートサブネット内のEC2インスタンスを立ち上げ、インスタンス内で以下のようにcompose.yamlファイルを作成します。

services:
  n8n:
    image: n8nio/n8n:latest
    container_name: n8n
    ports:
      - "5678:5678"
    environment:
      - GENERIC_TIMEZONE=Asia/Tokyo
      # Slackに登録するRequest URL(=外部公開URL)のベース。
      - WEBHOOK_URL=${PUBLIC_WEBHOOK_BASE_URL}
    volumes:
      - n8n_data:/home/node/.n8n
volumes:
  n8n_data:

compose.yamlを作成したら、以下のコマンドでn8nを起動します。

# DockerとDockerComposeはインストールされている前提
# n8nコンテナの起動
docker compose up -d

PUBLIC_WEBHOOK_BASE_URL は compose.yaml と同じ階層の .env などで設定します(Slackに登録するRequest URLのベースなので https のURLになります)。

セキュリティグループの設定

プライベートサブネット内のn8nは、外部からの不正アクセスを防ぐために、セキュリティグループで厳格なアクセス制御を設定します。

  • インバウンドルール:
    • ポート5678(n8nのUIアクセス):社内の踏み台/VPN/SSM経由など、運用方針に沿った経路のみに限定
    • ポート5678(Lambda → n8n 転送用):後述のLambda(またはLambdaに紐づくセキュリティグループ)からのみ許可

この設定により、社内からのみn8nの管理画面にアクセスでき、外部からの直接アクセスは遮断されます。

セルフホスト版n8nとSlackトリガー

Slackトリガーの基本設定

n8nでSlackトリガーノードを追加すると、SlackのEvent Subscriptionsに登録するためのRequest URL(Webhookエンドポイント)が提示されます。

このURLをSlackアプリのEvent Subscriptionsに設定することで、Slackでのイベント(メッセージ投稿、リアクション追加など)をトリガーにワークフローを実行できます。

問題:SlackのIPアドレスが固定されていない

ここで問題が発生します。Slackはグローバルな分散インフラストラクチャで運用されており、Webhookリクエストの送信元IPアドレスが固定されていません。そのため、セキュリティグループで特定のIPアドレスのみを許可する設定では、Slackからのリクエストを受け付けることができません。

かといって、すべてのIPアドレスからのアクセスを許可してしまうと、セキュリティリスクが高まり、プライベート環境に配置した意味がなくなってしまいます。

Lambdaを経由してn8nに送る

この問題を解決するために、AWS API Gateway + Lambdaを中継ポイントとして利用します。

この構成のポイントは以下です。

  • Slackは インターネット上のHTTPSエンドポイント(= API Gateway)にしか投げられない
  • n8nは プライベート環境内に閉じたまま、Lambdaからのみ到達可能にする
  • Slackリクエストは IP制限ではなく署名検証(Signing Secret) で正当性を担保する

注意点として、SlackのEvents APIには「最初のURL検証(url_verification)」や「応答は概ね3秒以内」などの要件があるため、Lambda側でそれを満たす実装にします。

API Gatewayの設定

API GatewayでREST APIを作成し、エンドポイントを公開します。このURLをSlackアプリのEvent SubscriptionsのRequest URLに設定します。

Lambda関数の実装

Lambda関数では以下の処理を実装します。

プライベートサブネット内にリクエストを送信するため、LambdaのVPC設定で上記のEC2と同じVPC・サブネットを設定します。またEC2のセキュリティグループで、Lambdaのセキュリティグループからのアクセスを許可します。

また環境変数(必要ならSecrets Manager等)にSLACK_SIGNING_SECRET と N8N_TRIGGER_URL を設定します。N8N_TRIGGER_URL はn8nが表示するWebhook URL(上記のPUBLIC_WEBHOOK_BASE_URL)の パスはそのままに、ベースだけを http://<EC2のIP>:5678 にしたものを使います。

Lambdaのコードは以下のようになります。

import os
import json
import hmac
import hashlib
import base64
from datetime import datetime
import requests

# Slackからのリクエスト検証 
def validate_request_from_slack(slack_signing_secret: str, headers: dict, body: str) -> bool:
    timestamp = headers.get("X-Slack-Request-Timestamp")
    slack_signature = headers.get("X-Slack-Signature")

    # 直近のリクエストか検証
    current_time = int(datetime.now().timestamp())
    if abs(current_time - int(timestamp)) > 60 * 5:
        return False

    # 署名検証
    sig_basestring = f"v0:{timestamp}:{body}"
    signature = (
        "v0="
        + hmac.new(
            slack_signing_secret.encode("utf-8"),
            sig_basestring.encode("utf-8"),
            hashlib.sha256,
        ).hexdigest()
    )
    return hmac.compare_digest(signature, slack_signature)

# n8nへのリクエスト転送
def send_n8n(n8n_trigger_url: str, body: dict) -> None:
    requests.post(
        url=n8n_trigger_url,
        headers={"Content-Type": "application/json"},
        json=body,
    )

def lambda_handler(event, context):
    headers = event.get("headers") or {}
    body = event.get("body") or ""
    if event.get("isBase64Encoded"):
        body = base64.b64decode(body).decode("utf-8")

    slack_signing_secret = os.environ.get("SLACK_SIGNING_SECRET", "")
    if not slack_signing_secret or not validate_request_from_slack(slack_signing_secret, headers, body):
        return {"statusCode": 401, "body": "invalid signature"}

    # SlackのURL検証(Event Subscriptionsを有効化する際に必須)
    try:
        payload = json.loads(body) if body else {}
    except json.JSONDecodeError:
        payload = {}
    if payload.get("type") == "url_verification":
        return {
            "statusCode": 200,
            "headers": {"Content-Type": "application/json"},
            "body": json.dumps({"challenge": payload.get("challenge", "")}),
        }

    n8n_trigger_url = os.environ.get("N8N_TRIGGER_URL", "")
    if not n8n_trigger_url:
        return {"statusCode": 500, "body": "missing N8N_TRIGGER_URL"}

    send_n8n(n8n_slack_trigger_url, payload)

    return {"statusCode": 200, "body": "ok"}

ポイント:

  • SlackのEvent Subscriptionsは最初に url_verification を投げてくるため、challenge応答がないと有効化できない
  • 署名検証は 「受け取った生のbody」 に対して行う(JSONとしてパースして並び替えると署名が一致しなくなる)

まとめ

セルフホスト版のn8nは、それ自体は無料(EC2料金は別途かかる)で使用でき、データも自社環境内に保持できるため、機密情報を扱う業務フローでも安心して利用できます。

また、非エンジニアの方でもn8nのGUIを使って安全に業務自動化を進められるようになり、組織全体の業務効率化に貢献できると考えています。

セキュリティ要件が厳しい環境でのワークフロー自動化を検討されている方の参考になれば幸いです。

テックブログのカテゴリ構成を見直した話

こんにちは!SaaS・DX事業部デザイナーの鍜治本です。 Qiitaアドベントカレンダー15日目を担当しています🎄

qiita.com

今回は、社内で運用しているテックブログの「カテゴリ構成」を見直した話を書きます。 記事の内容や技術そのものではなく、テックブログをどう整理・運用していくかという、少し裏側の話です。

なぜカテゴリ構成を見直すことにしたのか

このテックブログは、自分が入社する前から運用されていました。
当時は明確な運用ルールはなく、「まずは書くことを優先する」スタンスだったと聞いています。

立ち上げフェーズとしては自然な判断で、記事が積み重なったからこそ、カテゴリ構成の課題が見えるようになってきました。

ブログ基盤としての「はてなブログ」

ブログ基盤には、はてなブログを利用しています。

  • 1つの記事に複数カテゴリを付けられる
  • カテゴリに階層構造はない

自由度が高い一方で、ルールや設計をしないと、情報構造が散らかりやすい特性があります。

自分の過去ブログも自由にカテゴリを設定してました

改善前に抱えていたカテゴリの課題

粒度が揃っていないカテゴリ

改善前は、カテゴリの粒度がかなりバラバラでした。

登録されていたカテゴリーの一覧
例えば、

  • 「技術」という大きなカテゴリ
  • その中に並ぶ、言語名・ライブラリ名・概念的な話題

といった形で、抽象度の異なるものが同列に存在していました。

カテゴリ一覧を見ても、

  • このブログは何を扱っているのか
  • どんな切り口の記事が多いのか

が直感的に分かりづらい状態だったと思います。

運用ルールが存在しなかった影響

また、カテゴリに関する運用ルールがなかったため、

  • どのカテゴリを付けるかの判断が書き手ごとに異なる
  • 記事が増えるほど整理が難しくなる

といった問題も目立つようになってきました。

抽象的なものから具体的なものまで入り混じっている状態

カテゴリ構成をどう見直したか

今回のカテゴリ整備は、自分の判断で進めているものです。
現時点では正式な運用ルールではなく、まずは構造を整理してみる、という位置づけになります。

今後、ブログの状況を見ながら、ガイドラインとして整理していくことを想定しています。

親子構造を“間接的に”持たせる

はてなブログには階層カテゴリがないため、その制約の中で構造が伝わるような設計を考えました。

例えば、以下のような形です。

技術組織
└ 社内技術カンファレンス
 └ 年ごとのアーカイブ

カテゴリ名の付け方によって、間接的に親子関係が分かるようにしています。

見せ方の部分で階層構造(風)に

これにより、

  • 取り組み単位で記事をまとめられる
  • カテゴリ一覧から全体像が把握しやすくなる

といった効果を狙いました。

カテゴリ構造はこちらのサイトを参考に、ChatGPTと相談しながら進めて行きました。

maysun53.com

参考にした技術ブログ

カテゴリ設計を考えるにあたり、いくつか他社の技術ブログも参考にしました。

  • カテゴリの切り方
  • 年次・イベント単位での整理
  • 一覧性の作り方

「どんな情報を、どんな単位で見せたいか」が明確なブログほど、カテゴリ設計も整理されている印象でした。

参考にさせていただいたテックブログ(同じはてな形式のものを中心に調べました)
tech-blog.cluster.mu

www.m3tech.blog

techblog.tebiki.co.jp

developers.freee.co.jp

実際にやってみて分かったこと

良かった点

実際に整理してみて、良かったと感じている点です。

  • カテゴリ一覧がかなりスッキリした
  • 技術組織としての取り組みが見えやすくなった
  • 社内イベントや継続的な活動をまとめて追えるようになった

「記事単体」ではなく、「活動のまとまり」として読める構造になったのは大きな変化でした。

Before:アルファベット順に並ぶだけ After:抽象>具体の構造

デメリットと悩み

一方で、デメリットや難しさもあります。

  • 親カテゴリ自体にも、ある程度の記事や説明が必要になる
  • 気軽にカテゴリを増やせなくなった
  • まだ綺麗にまとまりきっていない部分もある

構造化した分、「とりあえずカテゴリを作る」ができなくなり、設計コストが上がってしまう結果に。

他社技術ブログを見て感じたこと

他社の技術ブログを見ていると、

  • カテゴリ数を意図的に増やさない
  • カテゴリ自体をあえて非表示にしている

といった設計も多く見かけました。

「カテゴリは必ずしも前面に出す必要はない」、という選択肢に気づけたのも、今回の整理の収穫です。

今後について

このブログは、検索経由で辿り着く方や、就職・転職の観点で見てくださっている方も多いと考えています。

だからこそ、

  • 構造が分かりやすいこと
  • 目的の記事に辿り着きやすいこと

を意識しながら、カテゴリ構成も運用しつつ育てていくつもりです。

ルール化できる部分は、少しずつ整えていければと思っています🙏